为什么2026年你必须关注DeepSeek-R1?
2025年1月,中国AI公司深度求索(DeepSeek)发布了一款名为DeepSeek-R1的开源大模型,引发了AI社区的广泛关注。这款模型在推理能力上对标OpenAI的o1系列,采用开放的开源协议,而且可以在自己的硬件上本地部署。对于关注AI大模型的你来说,这是一个值得了解的技术进展。需要先说明的是:完整版DeepSeek-R1参数规模很大(671B),个人电脑本地部署通常使用的是其蒸馏版小模型(如1.5B、7B、14B、32B等),本文后文所说的本地部署也主要指这些蒸馏版。
DeepSeek-R1最大的亮点在于其强大的推理能力。在数学推理、代码生成、逻辑分析等任务上,它的表现超越了同等规模的大多数模型。更重要的是,它采用了MIT开源协议,意味着你可以自由使用、修改甚至商业化部署,完全不用担心版权问题。
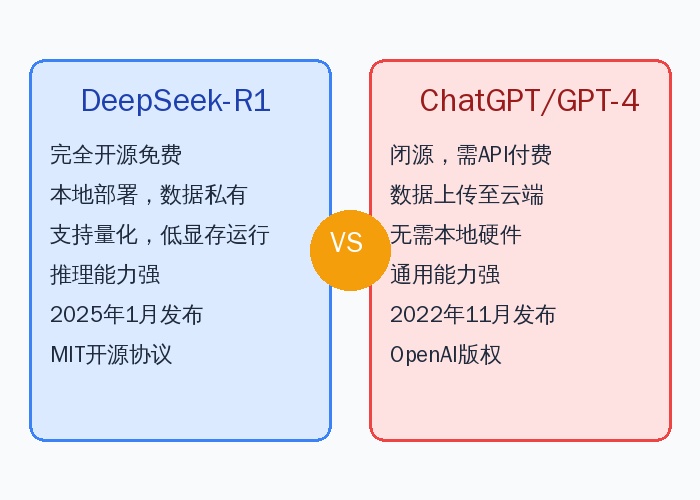
DeepSeek-R1 vs ChatGPT:核心差异
为了帮你快速理解DeepSeek-R1的定位,我们做一个直观对比:
| 对比维度 | DeepSeek-R1 | ChatGPT/GPT-4 |
|---|---|---|
| 开源协议 | MIT(完全免费商用) | 闭源(OpenAI版权) |
| 部署方式 | 本地部署,数据不出设备 | 云端API,数据上传至服务器 |
| 使用成本 | 一次性硬件投入,之后零成本 | 按token计费(价格因模型而异,以OpenAI官网为准) |
| 推理能力 | 数学/代码/逻辑推理极强 | 通用能力强,创意写作也出色 |
| 数据隐私 | 完全私有,符合GDPR | 数据经过OpenAI服务器 |
| 自定义 | 可微调、量化、二次开发 | 仅能通过API调用 |
| 离线可用 | 支持(无需网络) | 不支持(必须联网) |
本地部署的5大核心优势
相比使用在线AI服务,本地部署DeepSeek-R1具有以下不可替代的优势:
- 数据隐私保护:所有对话和数据处理都在你自己的服务器上完成,商业机密、个人数据永远不会离开你的设备。对于处理敏感信息的企业来说,这是合规的刚需。
- 零持续成本:一次性购买硬件后,使用成本几乎为零——只需要支付电费。相比每月数百元的API费用,投资回报期极短。
- 完全自主掌控:没有使用频率限制、没有内容审核、没有功能阉割。你可以选择任何模型版本,进行微调定制,一切由你决定。
- 离线运行:在网络信号差、断网环境或需要物理隔离的场景中,本地部署是唯一选择。对于工业控制、军事应用等场景至关重要。
- 2026年技术趋势:随着开源大模型生态的成熟,本地部署AI已经从极客尝试逐渐走向企业试点,越来越多团队开始在特定业务场景中评估和部署本地模型。
环境准备与硬件要求
在开始部署之前,我们需要确认你的硬件配置,并准备相应的软件环境。DeepSeek-R1的一个显著优势是对硬件要求相对亲民,不同的预算都有对应的部署方案。
硬件配置推荐方案
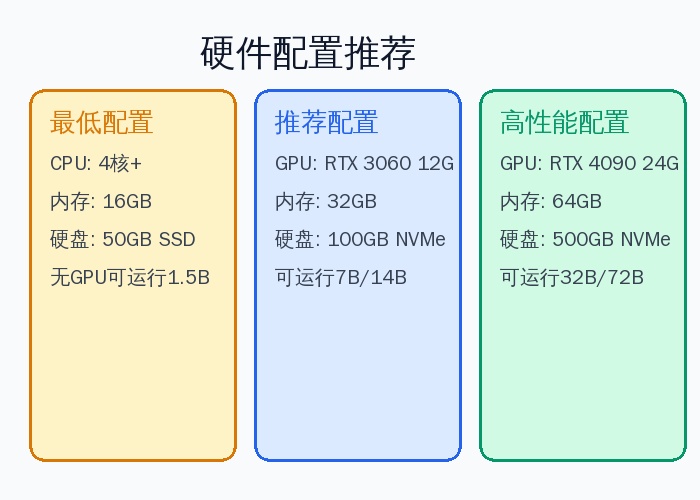
根据你的预算和需求,DeepSeek-R1的蒸馏版提供多种参数规模可选。以下是硬件匹配建议(实际速度和占用因量化方式、驱动和框架版本而异,仅供参考):
| 配置等级 | 硬件要求 | 可运行模型 | 推理速度 | 参考预算 |
|---|---|---|---|---|
| 最低配置 | 4核CPU + 16GB内存 + 50GB SSD | DeepSeek-R1-1.5B(蒸馏版)(Q4_K_M) | 5-10 token/s | ¥1000以下(旧电脑即可) |
| 推荐配置 | RTX 3060 12GB + 32GB内存 + 100GB NVMe | DeepSeek-R1-7B/14B(蒸馏版)(Q4_K_M) | 20-40 token/s | ¥4000-6000 |
| 高性能配置 | RTX 4090 24GB + 64GB内存 + 500GB NVMe | DeepSeek-R1-32B(蒸馏版)(Q4_K_M) | 15-30 token/s | ¥12000-18000 |
| 服务器配置 | 双路EPYC + A100 80GB | DeepSeek-R1-70B(蒸馏版)(Q4_K_M) | 5-15 token/s | ¥50000+ |
如果你没有独立显卡也不用担心。DeepSeek-R1-Distill-1.5B可以在纯CPU上运行,一颗普通的4核处理器就能达到可用的推理速度。关键是内存要留出余量:大致来说,1.5B量化后约需4GB内存,7B约需8GB显存或16GB内存,14B约需12GB显存/24GB内存,实际占用还会随上下文长度变化。
Ubuntu 24.04系统初始化
推荐使用Ubuntu 24.04 LTS作为部署系统。以下是系统初始化的完整步骤:
# 1. 更新系统
sudo apt update && sudo apt upgrade -y

# 2. 安装基础依赖
sudo apt install -y build-essential cmake git wget curl

# 3. 安装Python 3.12(部分工具需要)
sudo apt install -y python3.12 python3.12-venv python3-pip

# 4. 安装Docker(推荐方案需要)
curl -fsSL https://get.docker.com | sudo sh
sudo usermod -aG docker $USER
newgrp docker

# 5. 验证Docker安装
docker run hello-world
NVIDIA驱动与CUDA安装(GPU方案)
如果你使用GPU进行推理,需要安装NVIDIA驱动和CUDA工具包:
# 1. 安装NVIDIA驱动
sudo apt install -y nvidia-driver-550

# 2. 重启系统
sudo reboot

# 3. 验证驱动安装
nvidia-smi

# 4. 安装CUDA Toolkit(通过Docker方式更简便)
# 如果使用Docker部署,CUDA会自动通过NVIDIA Container Toolkit提供
sudo apt install -y nvidia-container-toolkit
sudo systemctl restart docker
安装完成后,运行 nvidia-smi 应该能看到你的GPU信息。如果显示驱动版本和显存大小,说明GPU环境已就绪。
三种部署方案详解
DeepSeek-R1支持多种部署方式,我们从简单到复杂逐一介绍。对于新手,强烈推荐方案一;追求性能的用户选择方案二;企业级用户考虑方案三。
方案一:Docker + Ollama(最简单,推荐新手)
如果你已经读过我们的Docker容器化部署完全指南,那么用Docker部署DeepSeek-R1将非常顺手。Ollama是目前最流行的本地大模型管理工具,它把模型下载、加载、推理全部封装成几条命令。
# 1. 拉取Ollama镜像
docker pull ollama/ollama:latest

# 2. 启动Ollama容器(GPU版本)
docker run -d --gpus all -v ollama_data:/root/.ollama \
  -p 11434:11434 --name ollama ollama/ollama:latest

# 3. 拉取DeepSeek-R1 7B模型
docker exec -it ollama ollama pull deepseek-r1:7b

# 4. 验证模型加载
docker exec -it ollama ollama list

# 5. 测试推理
curl http://localhost:11434/api/generate -d '{
  "model": "deepseek-r1:7b",
  "prompt": "1+1等于几?",
  "stream": false
}'这个方案的优势是隔离性好——所有依赖都在Docker容器中,不会污染你的系统环境。而且升级模型只需要一条命令。
方案二:llama.cpp + GGUF(性能最佳)
llama.cpp是用C++编写的推理引擎,是本地大模型推理的性能标杆。它支持各种量化格式(GGUF),可以在纯CPU上运行,也可以通过CUDA使用GPU加速。
# 1. 克隆并编译llama.cpp
git clone https://github.com/ggerganov/llama.cpp
cd llama.cpp
cmake -B build -DGGML_CUDA=ON
cmake --build build --config Release -j$(nproc)

# 2. 下载GGUF格式的DeepSeek-R1-Distill-Qwen-7B模型(社区量化仓库,文件名以仓库实际发布为准)
mkdir -p models
wget -O models/DeepSeek-R1-Distill-Qwen-7B-Q4_K_M.gguf \
  "https://huggingface.co/lmstudio-community/DeepSeek-R1-Distill-Qwen-7B-GGUF/resolve/main/DeepSeek-R1-Distill-Qwen-7B-Q4_K_M.gguf"

# 3. 启动推理服务
./build/bin/llama-server -m models/DeepSeek-R1-Distill-Qwen-7B-Q4_K_M.gguf \
  -c 4096 --host 0.0.0.0 --port 11434 -ngl 999
这个方案的优势是针对各种硬件做了深度优化,本地运行时的资源占用和延迟通常更可控。缺点是需要手动编译和配置。
方案三:vLLM(企业级部署)
vLLM是一个高性能的大模型推理和服务框架,专为生产环境设计。它支持PagedAttention技术,能最大化GPU显存利用率,支持Continuous Batching提升吞吐量。
# 1. 创建Python虚拟环境
python3 -m venv vllm-env
source vllm-env/bin/activate

# 2. 安装vLLM
pip install vllm

# 3. 启动DeepSeek-R1-Distill-Qwen-7B服务(模型名以官方仓库为准)
vllm serve deepseek-ai/DeepSeek-R1-Distill-Qwen-7B \
  --host 0.0.0.0 --port 11434 \
  --max-model-len 4096 \
--gpu-memory-utilization 0.9vLLM适合需要高并发服务的企业场景,支持OpenAI兼容API,可以直接替换ChatGPT API,方便现有项目迁移。
模型下载与量化
选择适合的模型版本
需要注意:完整版DeepSeek-R1为671B参数,主要面向服务器集群;个人和中小团队本地部署的通常是官方蒸馏版(Distill),参数规模从1.5B到70B不等。选择合适的版本需要在性能和资源之间平衡:
| 模型版本 | 参数量 | 量化后大小 | 最低显存/内存 | 推理能力 | 适用场景 |
|---|---|---|---|---|---|
| DeepSeek-R1-Distill-1.5B | 15亿 | ~1.1GB | 4GB内存 | 基础问答 | 嵌入式设备、测试环境 |
| DeepSeek-R1-Distill-7B | 70亿 | ~4.7GB | 8GB显存/16GB内存 | 代码/数学推理 | 个人使用、小型项目 |
| DeepSeek-R1-Distill-14B | 140亿 | ~8.4GB | 12GB显存/24GB内存 | 复杂推理 | 中型项目、企业应用 |
| DeepSeek-R1-Distill-32B | 320亿 | ~19GB | 24GB显存/48GB内存 | 高级推理 | 大型企业、研究机构 |
Q4_K_M量化详解
量化是将模型从FP16/BF16压缩到更低精度的过程,能在几乎不损失推理质量的前提下大幅减少显存占用。Q4_K_M是目前最推荐的量化方案:
- Q4_K_M:4-bit量化,关键层使用6-bit,平衡性能和质量
- Q5_K_M:5-bit量化,质量更高但体积更大
- Q8_0:8-bit量化,接近原始质量但占用更多资源
- F16:不量化,原始精度,需要最大显存
对于大多数用户,Q4_K_M是比较稳妥的选择——它能大幅减少显存占用,同时较好地保留模型的推理能力。
启动服务与API对接
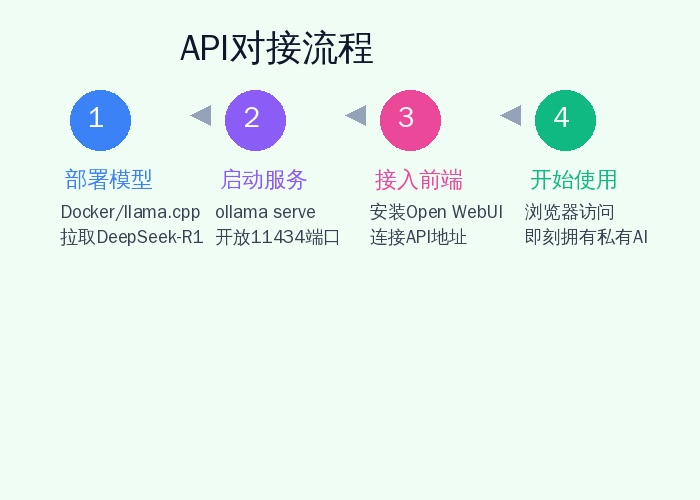
启动推理服务
以Docker + Ollama方案为例,启动推理服务非常简单:
# 启动Ollama服务(如果尚未运行)
docker start ollama

# 检查服务状态
curl http://localhost:11434/api/tags

# 响应示例:
# {"models":[{"name":"deepseek-r1:7b","size":4661224676,...}]}
如果返回了模型列表,说明推理服务已经正常运行。你可以通过API直接与模型交互。
OpenAI兼容API接口配置
Ollama和vLLM都提供了与OpenAI API兼容的接口,这意味着你可以直接使用所有支持OpenAI API的工具和框架,无缝切换:
import openai

# 配置本地API(兼容OpenAI接口格式)
client = openai.OpenAI(
    base_url="http://localhost:11434/v1",
    api_key="ollama"  # Ollama不验证key,任意值即可
)

# 聊天补全
response = client.chat.completions.create(
    model="deepseek-r1:7b",
    messages=[
        {"role": "system", "content": "你是一个专业的技术助手。"},
        {"role": "user", "content": "解释什么是Docker容器化部署?"}
    ],
    temperature=0.7,
    max_tokens=2048
)

print(response.choices[0].message.content)
这种兼容设计的价值在于:你可以将本地DeepSeek-R1作为ChatGPT API的替代品,所有基于OpenAI API开发的项目都能无缝切换,而且数据完全私有。
接入Open WebUI图形界面
如果你更喜欢图形界面而非命令行,可以部署Open WebUI(原名Ollama WebUI),它提供了一个类似ChatGPT的Web界面:
# 启动Open WebUI容器
docker run -d -p 3000:8080 \
  --add-host=host.docker.internal:host-gateway \
  -v open-webui_data:/app/backend/data \
  --name open-webui --restart always \
  ghcr.io/open-webui/open-webui:main

# 浏览器访问 http://你的服务器IP:3000
# 首次使用创建管理员账号,然后在设置中配置Ollama API地址
# API地址填写:http://host.docker.internal:11434
部署完成后,浏览器访问 http://你的服务器IP:3000 即可使用类似ChatGPT的界面与DeepSeek-R1交互。支持多对话管理、模型切换、对话历史等功能。
实际应用场景
智能客服与问答系统
DeepSeek-R1的推理能力非常适合构建企业智能客服系统。相比传统的关键词匹配客服,基于大模型的客服能理解用户的真实意图,给出更准确的回答。
部署方案:将DeepSeek-R1通过API接入你的网站或APP,配合向量数据库(如ChromaDB或Milvus)构建RAG(检索增强生成)系统。用户提问时,先从知识库检索相关文档,再将文档和问题一起发送给模型生成回答。
代码辅助与文档分析
DeepSeek-R1在代码生成方面表现出色。你可以用它来:
- 代码审查:将代码片段发送给模型,请求代码审查和改进建议
- 文档生成:根据代码自动生成API文档、README文件
- Bug排查:将错误日志发送给模型,请求问题分析和解决方案
- 代码翻译:将Python代码翻译为Go、Rust等其他语言
企业内部知识库
利用RAG技术,将公司的内部文档、操作手册、产品资料等构建成知识库,员工可以通过自然语言提问快速获取信息。这种方式比传统的文档搜索更直观、更高效。
构建流程:文档切片 → 向量化(Embedding) → 存入向量数据库 → 用户提问时检索相关片段 → 结合DeepSeek-R1生成回答。整个流程可以参考我们之前发布的AI大模型本地部署实战中的RAG章节。
性能优化与常见问题
显存与内存优化技巧
如果你发现模型运行缓慢或显存不足,可以尝试以下优化方法:
- 使用更低的量化精度:从Q5_K_M降到Q4_K_M,显存占用会进一步降低
- 限制上下文长度:通过
--max-model-len参数限制最大token数,减少显存占用 - 启用Flash Attention:在支持的硬件和框架上开启后,有助于降低显存占用、提升长文本推理效率
- CPU内存交换:当显存不足时,部分计算可以转移到CPU内存(速度会降低)
- 批量推理:使用vLLM的Continuous Batching功能提升吞吐量
推理速度提升方法
| 优化方法 | 提速幅度 | 操作难度 | 适用场景 |
|---|---|---|---|
| 使用GPU替代CPU | 明显提升(视硬件而定) | 简单 | 所有场景 |
| 开启Flash Attention | 有一定提升(视场景而定) | 中等 | 长文本推理 |
| 使用量化模型Q4_K_M | 相对于FP16节省75%显存 | 简单 | 显存受限时 |
| 启用CUDA Graph | 有一定提升 | 中等 | 固定长度请求 |
| vLLM替代Ollama | 吞吐量更高(视场景而定) | 中等 | 高并发场景 |
常见错误排查
| 错误现象 | 可能原因 | 解决方案 |
|---|---|---|
| CUDA out of memory | 显存不足 | 使用更小的模型(7B→1.5B)或更低量化(Q5→Q4) |
| 模型下载失败 | 网络问题或HuggingFace访问受限 | 使用镜像站或手动下载模型文件 |
| 推理速度极慢 | 未使用GPU,在CPU上运行 | 安装NVIDIA驱动,使用Docker GPU模式 |
| API返回404 | Ollama服务未启动或端口被占用 | 检查容器状态:docker ps -a |
| 中文输出乱码 | 编码问题 | 设置环境变量 LANG=zh_CN.UTF-8 |
| Docker容器无法使用GPU | NVIDIA Container Toolkit未安装 | 安装 nvidia-container-toolkit 并重启Docker |
总结与下一步
DeepSeek-R1是近年来备受关注的开源推理模型之一。通过本文介绍的三种部署方案,无论你是有旧电脑想试试的新手,还是有专业GPU追求性能的开发者,或者是需要企业级部署的团队,都能找到合适的方案。具体模型版本与参数请以DeepSeek官方发布为准。
本地部署AI的核心价值在于数据私有、零持续成本、完全自主掌控。在数据安全和隐私日益重要的2026年,掌握这项技能不仅是技术能力的体现,更是企业竞争力的保障。
相关推荐
如果你对AI大模型的应用还有以下兴趣,推荐阅读我们网站的相关文章:
- 🤖 2026年AI大模型本地部署实战:从零搭建你的私有AI助手 — 如果你还没读过这篇基础教程,建议先从这里开始,涵盖了Ollama、LM Studio等多种部署工具的详细对比。
- 🐳 2026年Docker容器化部署完全指南:从入门到生产环境实战 — 本文方案一依赖Docker,如果你对Docker还不熟悉,这篇教程从零讲起,包含大量实战案例。
- 🔒 2026年数据丢失防范完全指南 — 部署本地AI后,你的对话数据会存储在服务器上。了解如何备份和保护这些数据同样重要。
- 🤖 2026年AI自动化三大机器人深度对比:Codex vs Hermes vs OpenClaw — 如果你对AI自动化感兴趣,这篇文章从代码生成到物理控制,系统梳理了AI自动化的三个层次。
开始部署你自己的DeepSeek-R1吧!如果在部署过程中遇到问题,欢迎在评论区留言,我们会尽力解答。